Chatbot ou voicebot pédagogique : lequel choisir ?
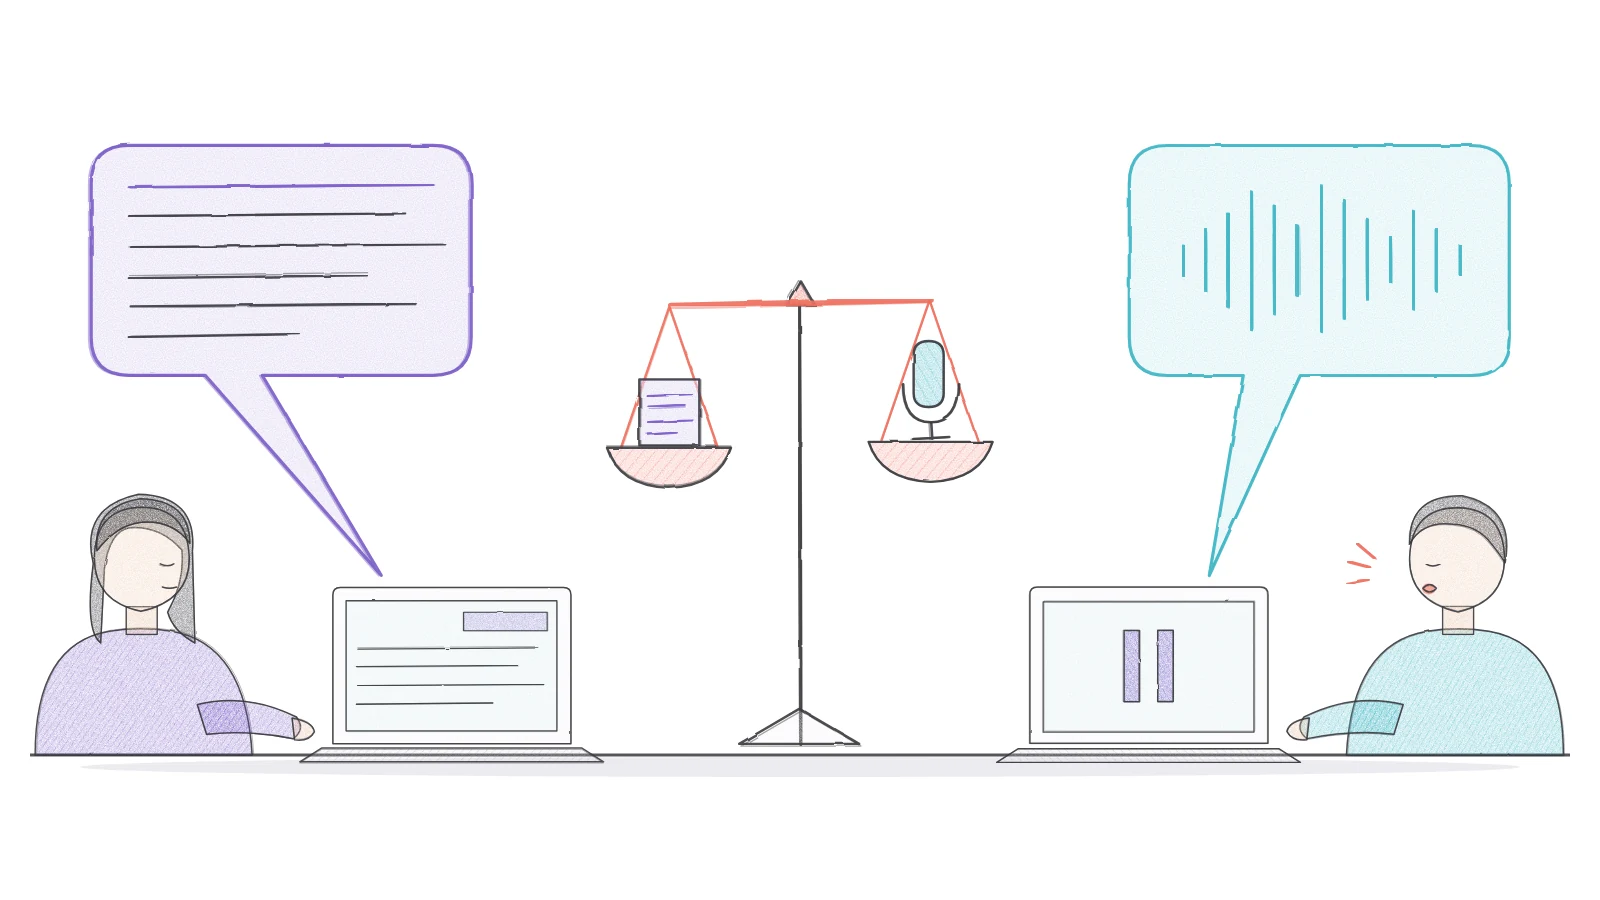
Un assistant conversationnel peut répondre aux apprenants par écrit, comme un chatbot, ou à la voix, comme un voicebot. Le choix ne relève pas d’une préférence technologique : il dépend de ce que fait l’apprenant au moment où il pose sa question, de la longueur des réponses attendues, de l’accessibilité et des données traitées. Cet article compare les deux canaux sur quatre critères (accessibilité, pédagogie, coût, expérience) et propose une grille pour choisir l’écrit, la voix ou une combinaison des deux.
La réponse courte
Le voicebot convient quand l’apprenant a les yeux sur un autre support, une vidéo ou un geste à reproduire, et que la réponse attendue est courte. Le chatbot convient quand la réponse est longue, technique ou doit être relue, et quand l’apprenant ne peut pas parler à voix haute. Dans beaucoup de parcours, la bonne réponse est une combinaison : la voix pour questionner pendant le cours, l’écrit comme alternative et comme trace. Le fonctionnement de DidacticBot, qui répond à la voix pendant les vidéos de formation, est présenté sur la page Fonctionnalités.
Chatbot, voicebot : ce qui les distingue vraiment
Un chatbot pédagogique est un agent conversationnel avec lequel l’apprenant échange par écrit. Un voicebot pédagogique, ou assistant conversationnel vocal, reçoit la question à l’oral, la transcrit grâce à la reconnaissance vocale, puis répond par synthèse vocale. Les deux peuvent s’appuyer sur le même moteur de réponse et sur les mêmes contenus de formation : la différence tient d’abord au canal d’entrée et de sortie, et à tout ce qu’il implique pour l’apprenant.
Il existe aussi des formes mixtes : une question posée à la voix avec une réponse affichée, une question écrite avec une réponse lue à voix haute, ou une réponse vocale accompagnée de sa transcription. Pour une définition plus large de la conversation avec un agent pendant un cours, voir notre article sur l’e-learning conversationnel.
Comparatif sur quatre critères
| Critère | Chatbot (écrit) | Voicebot (vocal) |
|---|---|---|
| Accessibilité | Utilisable avec un lecteur d’écran si l’interface est accessible, et sans parler ; demande de savoir formuler sa question par écrit | Utile à qui a du mal à taper ou à écrire ; exclut sans alternative les personnes sourdes, malentendantes ou ayant des difficultés d’élocution |
| Pédagogie | Adapté aux réponses longues, aux procédures et aux termes techniques, que l’on peut relire | Adapté aux explications courtes pendant une vidéo ou une tâche, sans détourner le regard |
| Coût | Repose sur le traitement des questions et la production des réponses | Ajoute la reconnaissance et la synthèse vocales, des tests de reconnaissance avec les apprenants et une alternative écrite |
| Expérience | Discret en open space ou dans les transports ; plus lent à saisir | Plus rapide à formuler ; gêné par le bruit et peu adapté aux lieux partagés |
Ce tableau est une grille d’analyse, pas un classement : chaque critère se pondère selon le public, le lieu de formation et l’objectif pédagogique. Les sections suivantes détaillent ce que disent les recherches et les textes sur chaque point.
Accessibilité : aucun canal unique ne convient à tous
Le W3C a recensé les besoins des personnes en situation de handicap face aux interfaces en langage naturel, écrites ou vocales, dans une note de groupe de travail publiée en 2022 (Natural Language Interface Accessibility User Requirements). Plusieurs exigences concernent directement le choix entre chatbot et voicebot : prendre en charge plusieurs modes de saisie et de restitution, proposer une transcription textuelle synchronisée des réponses vocales, permettre une saisie écrite avec une réponse vocale pour les personnes ayant des troubles de la parole, et laisser l’utilisateur changer de mode de saisie à tout moment. Le document rappelle aussi que la saisie vocale est cognitivement exigeante.
La qualité de la reconnaissance vocale varie par ailleurs selon les locuteurs. Une étude publiée en 2020 dans PNAS a testé cinq systèmes commerciaux de reconnaissance vocale en anglais américain : le taux moyen d’erreur sur les mots atteignait 0,35 pour des locuteurs noirs contre 0,19 pour des locuteurs blancs. Ces chiffres concernent des systèmes testés avant 2020 et une langue précise ; ils montrent surtout qu’il faut tester un voicebot avec la diversité réelle des voix, des accents et des façons de parler des apprenants.
Pédagogie : la voix pour les réponses courtes, l’écrit pour les longues
Poser sa question : la parole va plus vite
Une étude de l’université Stanford et de l’université de Washington, publiée dans les Proceedings of the ACM on Interactive, Mobile, Wearable and Ubiquitous Technologies (IMWUT) fin 2017, a comparé la saisie vocale et le clavier d’un smartphone auprès de 48 participants, en anglais et en mandarin. Pour recopier de courtes phrases, la dictée était environ 2,9 fois plus rapide que le clavier. L’expérience s’est déroulée dans une salle calme, avec des phrases imposées : elle ne mesure pas une conversation pédagogique, mais elle suggère que formuler une question à l’oral demande moins de temps que de la taper.
Comprendre la réponse : l’oral long se retient mal
Côté réponse, la recherche sur la charge cognitive apporte une nuance importante. Dans deux expériences publiées en 2016 dans Instructional Science, portant sur l’apprentissage de la lecture d’une carte topographique, Wayne Leahy et John Sweller ont observé qu’une explication orale longue accompagnant un visuel donnait de moins bons résultats que le même contenu écrit. Une explication orale ne l’emportait sur l’écrit que lorsqu’elle était très courte, ce qu’ils n’ont obtenu qu’après l’avoir encore raccourcie dans la seconde expérience. Les auteurs l’expliquent par l’effet d’information transitoire : un énoncé oral disparaît à mesure qu’il est prononcé et doit être retenu en mémoire de travail, alors qu’un texte reste disponible.
Pour un assistant pédagogique, on peut en tirer une règle prudente : la voix convient aux reformulations brèves pendant que l’apprenant regarde une vidéo ou un schéma ; l’écrit convient aux procédures en plusieurs étapes, aux valeurs chiffrées, aux définitions à mémoriser et à tout ce que l’apprenant voudra relire. Pour tester une interaction vocale de bout en bout et prévoir une alternative silencieuse, voir notre article sur l’interaction vocale en formation.
Coût : les postes à examiner, sans chiffre de principe
Il n’existe pas de coût de référence fiable pour comparer un chatbot et un voicebot pédagogiques : les tarifs dépendent du fournisseur, du volume d’échanges, des langues et du mode de facturation. Plutôt qu’un chiffre, comparez les postes de dépense et demandez-les explicitement aux éditeurs.
- Commun aux deux : préparation et mise à jour des contenus sur lesquels l’assistant s’appuie, traitement des questions, relecture des réponses par l’équipe pédagogique.
- Spécifique à la voix : reconnaissance vocale de chaque question, synthèse vocale de chaque réponse, tests de reconnaissance avec des apprenants réels, conservation éventuelle des enregistrements.
- Spécifique à l’accessibilité : alternative écrite ou transcription pour les apprenants qui ne peuvent pas utiliser la voix.
- Côté apprenants : micro et casque fonctionnels, lieu calme ou espace dédié pour se former à voix haute.
Expérience et données : le lieu de formation décide souvent
Le meilleur canal sur le papier peut devenir inutilisable sur le terrain. Un voicebot est peu adapté à un open space, à un espace de vente ou aux transports, où l’apprenant hésitera à parler et où le bruit gêne la reconnaissance. Il devient au contraire pertinent quand l’apprenant suit une vidéo, manipule un équipement ou se forme seul dans un lieu calme. Un chatbot reste discret partout, mais impose de quitter des yeux le contenu pour lire et écrire.
La voix soulève aussi des questions propres de protection des données. Dans ses lignes directrices 02/2021 sur les assistants vocaux virtuels (version 2.0 adoptée le 7 juillet 2021), le Comité européen de la protection des données (CEPD) rappelle que les données vocales sont des données personnelles, qu’elles relèvent de l’article 9 du RGPD lorsqu’elles sont traitées pour identifier une personne de manière unique, et qu’un enregistrement peut capter la voix d’autres personnes ou des bruits de fond. Il recommande notamment de limiter le type et la quantité de données collectées et d’informer les utilisateurs au plus tard au moment de l’obtention de leurs données (texte consulté le 19 novembre 2026).
Exemple : la voix pendant les vidéos DidacticBot
DidacticBot a fait le choix de la voix au moment où l’apprenant regarde une vidéo de formation : la vidéo se met automatiquement en pause quand l’apprenant pose sa question ; l’IA répond à la voix sur les contenus pédagogiques. L’apprenant demande ensuite la reprise de la vidéo après l’échange. Les éventuelles alternatives (écrit, transcription) pour les apprenants qui ne peuvent pas utiliser la voix sont à examiner avec l’équipe pour chaque projet.
Grille de choix : huit questions à se poser
- Que fait l’apprenant au moment où il pose sa question : regarde-t-il une vidéo, manipule-t-il un équipement, lit-il un document ?
- Les réponses attendues sont-elles courtes, ou s’agit-il de procédures, de chiffres et de définitions à relire ?
- Où l’apprenant se forme-t-il : lieu calme, open space, magasin, transports ?
- Quelles situations de handicap et quels profils linguistiques compte votre public ?
- L’outil permet-il de changer de canal à tout moment et propose-t-il une transcription des réponses vocales ?
- La reconnaissance vocale a-t-elle été testée avec des apprenants représentatifs de votre public ?
- Quelles données vocales sont enregistrées, combien de temps, et la voix sert-elle à identifier l’apprenant ?
- Quels postes de coût propres à la voix l’éditeur facture-t-il, et sur quelle base ?
À retenir
Choisir entre chatbot et voicebot pédagogique revient à choisir un canal adapté à une situation d’apprentissage. La voix accélère la question et laisse les yeux libres pour le contenu, mais se prête mal aux réponses longues et exclut une partie des apprenants sans alternative écrite. L’écrit se relit et reste discret, au prix d’un effort de saisie. Partez des situations réelles de vos apprenants, testez avec eux, et prévoyez dans tous les cas un moyen de passer d’un canal à l’autre.
Sources et portée des références
- [w3c-naur-2022] Natural Language Interface Accessibility User RequirementsW3C, Accessible Platform Architectures Working Group, Group Draft Note du 3 septembre 2022 ; consulté le 19 novembre 2026.
Besoins et exigences d’accessibilité des interfaces en langage naturel (écrites et vocales) : modes de saisie multiples, transcription synchronisée, changement de mode. Note de groupe, non normative.
- [koenecke-2020] Racial disparities in automated speech recognitionKoenecke A., Nam A., Lake E. et al., PNAS, vol. 117, n° 14, p. 7684–7689, 2020.
Cinq systèmes commerciaux de reconnaissance vocale testés en anglais américain ; taux d’erreur moyen sur les mots de 0,35 contre 0,19 selon les groupes de locuteurs.
- [ruan-2017] Comparing Speech and Keyboard Text Entry for Short Messages in Two Languages on Touchscreen PhonesRuan S., Wobbrock J. O., Liou K., Ng A., Landay J. A., Proceedings of the ACM on Interactive, Mobile, Wearable and Ubiquitous Technologies, vol. 1, n° 4, article 159, décembre 2017.
Expérience en laboratoire auprès de 48 participants (anglais et mandarin), recopie de phrases courtes sur smartphone ; ne mesure pas un usage pédagogique.
- [leahy-sweller-2016] Cognitive load theory and the effects of transient information on the modality effectLeahy W., Sweller J., Instructional Science, vol. 44, n° 1, p. 107–123, 2016.
Deux expériences (lecture de carte topographique) : un texte oral long est moins efficace que le même texte écrit ; un texte oral très court devient plus efficace (effet d’information transitoire).
- [edpb-lignes-directrices-02-2021] Lignes directrices 02/2021 sur les assistants vocaux virtuels, version 2.0Comité européen de la protection des données (CEPD), adoptées le 7 juillet 2021 ; texte consulté le 19 novembre 2026.
Données vocales, article 9 du RGPD en cas d’identification, minimisation, voix de tiers, information des utilisateurs. Ne constitue pas une analyse de conformité d’un outil donné.
Écrit, voix ou les deux : quel canal pour vos apprenants ?
Présentez vos publics, vos lieux de formation et vos supports à l’équipe pour examiner le fonctionnement et les modalités à confirmer pour votre projet.
Demander une démo